CodeFormer 保真度权重 w 详解:质量与身份该怎么平衡
w 权重是 CodeFormer 的灵魂
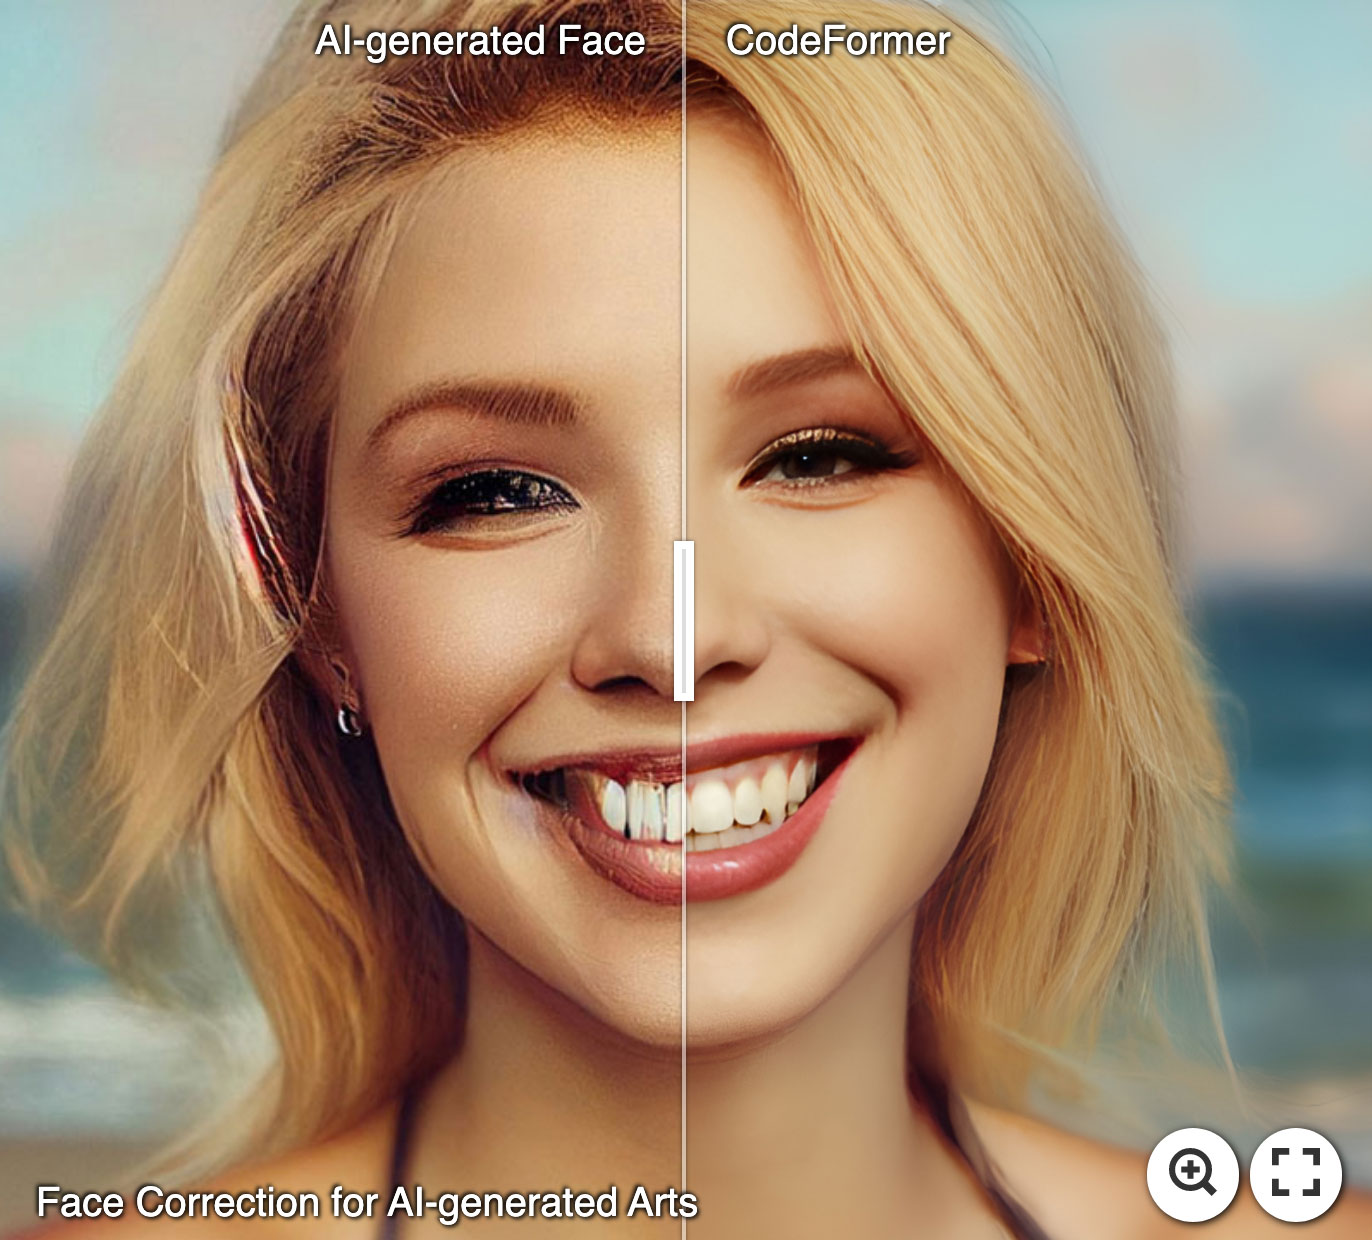
GFPGAN 没有 w 权重——它是个纯生成模型,输出只有一个"看起来最像真人"的结果。CodeFormer 不一样:它在质量和身份之间给了你一把精确的滑块。
这个滑块的工作原理在 模型原理 页已经解释过:w 控制残差连接的信息流量。这里聚焦于怎么用它。
w 值的两端
w = 0:纯 Codebook 重建
python inference_codeformer.py -w 0 --input_path face.jpg- 输出画面最干净、最漂亮
- 皮肤纹理、眼睛细节会被 Codebook 里匹配到的视觉原子替换
- 风险:如果 Codebook 里找不到和原图完全匹配的纹理,模型会选"最像的"——可能把你的痣去掉、把眼型微调、把皮肤磨得过于光滑
- 适用:AI 生图后处理(本来就不是真人,不存在"改人"问题)、只想得到一张好看的头像
w = 1:最大身份保真
python inference_codeformer.py -w 1 --input_path face.jpg- 模型会尽量从原图里保留一切能保留的信息
- 原图里的噪点、轻微模糊、偏色也会被一起保留下来
- 风险:当原图退化严重时,w=1 的结果可能"什么都想保但什么都没修好"
- 适用:有明确身份识别需求的场景(警方档案修复、名人照片)、视频逐帧处理(保持时间一致性)
w = 0.5(默认)
- 居中策略,两边都妥协一点
- 对大多数日常场景够用
实际观察:w 值变化的视觉规律
从 0 到 1 滑动时,你会观察到:
- 皮肤纹理:w 越小,皮肤越光滑(Codebook 里匹配到的都是高质量皮肤纹理);w 越大,原图的粗糙皮肤、毛孔、小痣会逐步回来
- 眼睛区域:w 最敏感的区域之一。w=0 时瞳孔颜色、反光点可能被改写;w=1 时能保住原图的反光点
- 轮廓边缘:w 小,脸型可能被微调得更对称;w 大,保持原图脸型
- 背景融合:整图处理时,w 越大,人脸和背景的交界越自然(因为保留了更多原图的空间特征)
分场景推荐 w 值
| 场景 | 推荐 w | 理由 |
|---|---|---|
| 老照片修复(家人长辈) | 0.6 ~ 0.8 | 身份优先,别把长辈修成网红脸 |
| 老照片(年代久远、褪色) | 0.5 ~ 0.6 | 平衡画质和身份 |
| AI 生图后处理 | 0.2 ~ 0.4 | 本来就不是真人,要自然就行 |
| 人像特写(美颜增强) | 0.3 ~ 0.5 | 皮肤光滑但五官不崩 |
| 警方档案 / 身份证照片 | 0.8 ~ 1.0 | 身份绝对优先 |
| 视频逐帧处理 | 1.0 | 保证同一人前后帧长相一致 |
| JPEG 重压缩 artifact | 0.5 ~ 0.7 | 去伪影但保住细节 |
调参技巧
方法一:对比三张(快)
在 HuggingFace Demo 或本地 CLI 同时跑三张:w=0.3 / 0.6 / 0.9,肉眼比对选最满意的。
方法二:线性插值(精)
如果有 GPU 时间,可以跑 w=0 到 w=1 每 0.1 一张,观察哪一张从"开始变丑"到"开始变不像本人"——取中间值。
方法三:先跑小 w,再逐步加大
先跑 w=0 看纯 Codebook 重建能修到什么程度,然后逐步加大 w 直到"开始像原图本人"为止,取那个临界点。
w 权重的底层限制
w 权重不是万能的,有两个硬限制:
1. 原图没信息,w=1 也救不了
如果原图的眼睛区域完全糊了,w=1 只能保留"糊的眼睛",它不会凭空变出眼球细节。此时 w 再大也只是把模糊放大。
2. w 是线性标量,不是区域感知
整张脸用同一个 w 值。你不能指定"眼睛区域用 w=0.8、皮肤区域用 w=0.2"。如果需要区域差异化处理,就得用其他工具(如局部 mask 的 inpainting)配合。
和 GFPGAN 的对比
GFPGAN 没有 w 权重,但有一个隐含的"风格"——它的 GAN 判别器倾向于输出看起来像"网红脸"的结果。所以:
- 如果你的目标是"尽量像本人",CodeFormer + 大 w 永远优于 GFPGAN
- 如果你的目标是"只要好看就行",GFPGAN 一键足够
小结
w 权重是 CodeFormer 最值得花时间研究的特性。对于每张图,先想清楚:这张图里,"好看"和"像本人"哪个更重要?然后选 w 值。大多数人的默认起点可以是 w=0.6,再往两边调。