CodeFormer 模型原理:Codebook Lookup Transformer 为什么比 GAN 更稳
盲人脸修复的老问题
传统人脸修复面临一个核心矛盾:低清图 → 高清图 是一对多映射。同一张模糊的人脸可能对应无数张清晰的脸——皮肤纹理、眼睛细节、微表情都不确定。
GFPGAN 这类 GAN 路线的做法是:用判别器约束输出"看起来像真的人脸"。好处是激进、干净;坏处是容易改人——GAN 倾向于把模糊的眼睫毛画成标准完美眼睫毛,把原来的痣去掉。
CodeFormer 的解法:变成代码预测问题
CodeFormer 换了一条路——不直接生成像素,而是先把人脸表示成一串离散代码 token,再解码。
整个模型分三段训练:
阶段一:Codebook 预训练
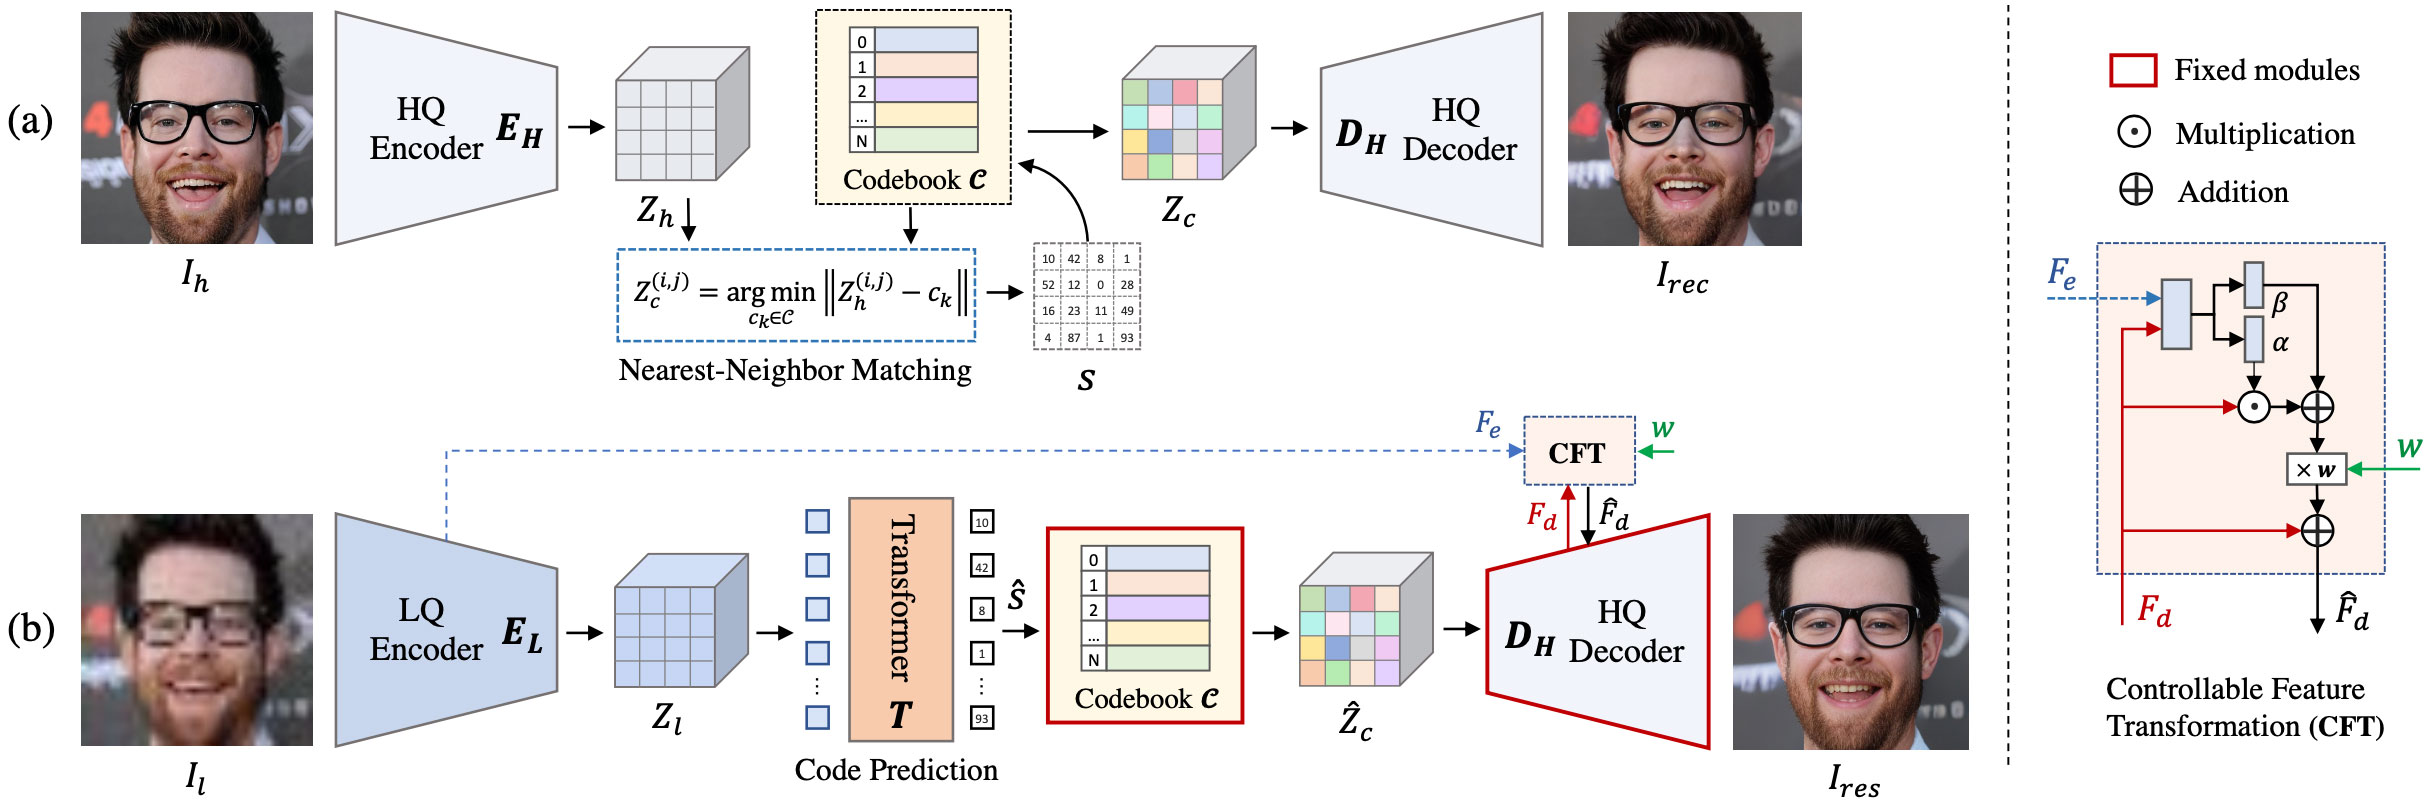
先用高质量人脸图(FFHQ 数据集)训练一个 Codebook 和一个 Decoder:
- Codebook:一张"人脸视觉原子表",每行是一个 256 维的 embedding 向量,代表人脸里常见的一小块纹理单元
- Decoder:给定一串 token 序列,能把它们拼成一张完整的人脸图
这一步相当于让模型背下来"人脸常见的零件都长什么样"。
阶段二:Transformer 代码预测
固定住 Codebook 和 Decoder,换上 Transformer 网络:
- 输入:低清人脸特征
- 输出:最可能匹配的 token 序列
- 训练目标:预测出的 token 解码后和原图越像越好
Transformer 的优势是 全局建模——它能同时看到整张脸的结构关系,不会像卷积网络那样只盯着局部。
阶段三:可控特征变换(w 权重)
这是 CodeFormer 最独特的模块。模型有一条残差连接直接从低清编码器通往解码器,这条连接的信息流量由标量 w 控制:
- w → 0:几乎切断残差连接,解码器只靠 Codebook token 重建 → 画面干净漂亮,但身份可能有变化(因为 token 池里找了最匹配的视觉元素,但不一定是原图的元素)
- w → 1:残差连接全开,解码器融合更多原图信息 → 身份保真度高,但低清图里的噪声、模糊也会被保留
- w 默认 0.5:居中,两边都照顾一点
推理时发生了什么
给定一张整图:
- 人脸检测 + 对齐(用 YOLOv5-face 或 dlib)
- 检测到的人脸区域裁出来,缩放到 512×512
- 送入 CodeFormer 推理 → 得到修复后的 512×512 人脸
- 把修复脸粘贴回原图(back projection 方式对齐边界)
- 如果开了
--bg_upsampler realesrgan,背景区域也用 Real-ESRGAN 增强 - 输出融合后的完整图片
为什么 CodeFormer 更稳
| 维度 | GAN(GFPGAN) | CodeFormer |
|---|---|---|
| 推理框架 | 生成器 + 判别器对抗 | 确定性 Codebook 查找 + Transformer 预测 |
| 身份保持 | 靠判别器引导,容易漂 | Codebook token 有明确约束,更稳定 |
| 控制能力 | 几乎不可调 | w 权重在 0-1 之间线性可调 |
| 严重退化 | 可能瞎编 | 从 Codebook 里找最接近的,不会乱编 |
| 训练成本 | 对抗训练不稳定 | 两阶段训练更可控 |
但 CodeFormer 不是万能的
- 对完全看不清的脸(严重马赛克、极度模糊),w=1 时也救不回来,因为原图没有信息可以保持;w=0 又会编一张"最像真的人脸"但不是本人
- 整图处理时的边界融合会在头发、下颌线附近产生伪影——这是所有两阶段方法(先修脸再贴回)的共性
- 纯人脸修复不处理背景、衣服、文字——这些需要 Real-ESRGAN 搭配
延伸阅读
- 原论文:Towards Robust Blind Face Restoration with Codebook Lookup Transformer(NeurIPS 2022)
- 项目主页作者 Shangchen Zhou 的个人网站有更多可视化 demo
- HuggingFace 和 Replicate 上有在线 playground 可以亲手调 w 值观察变化